
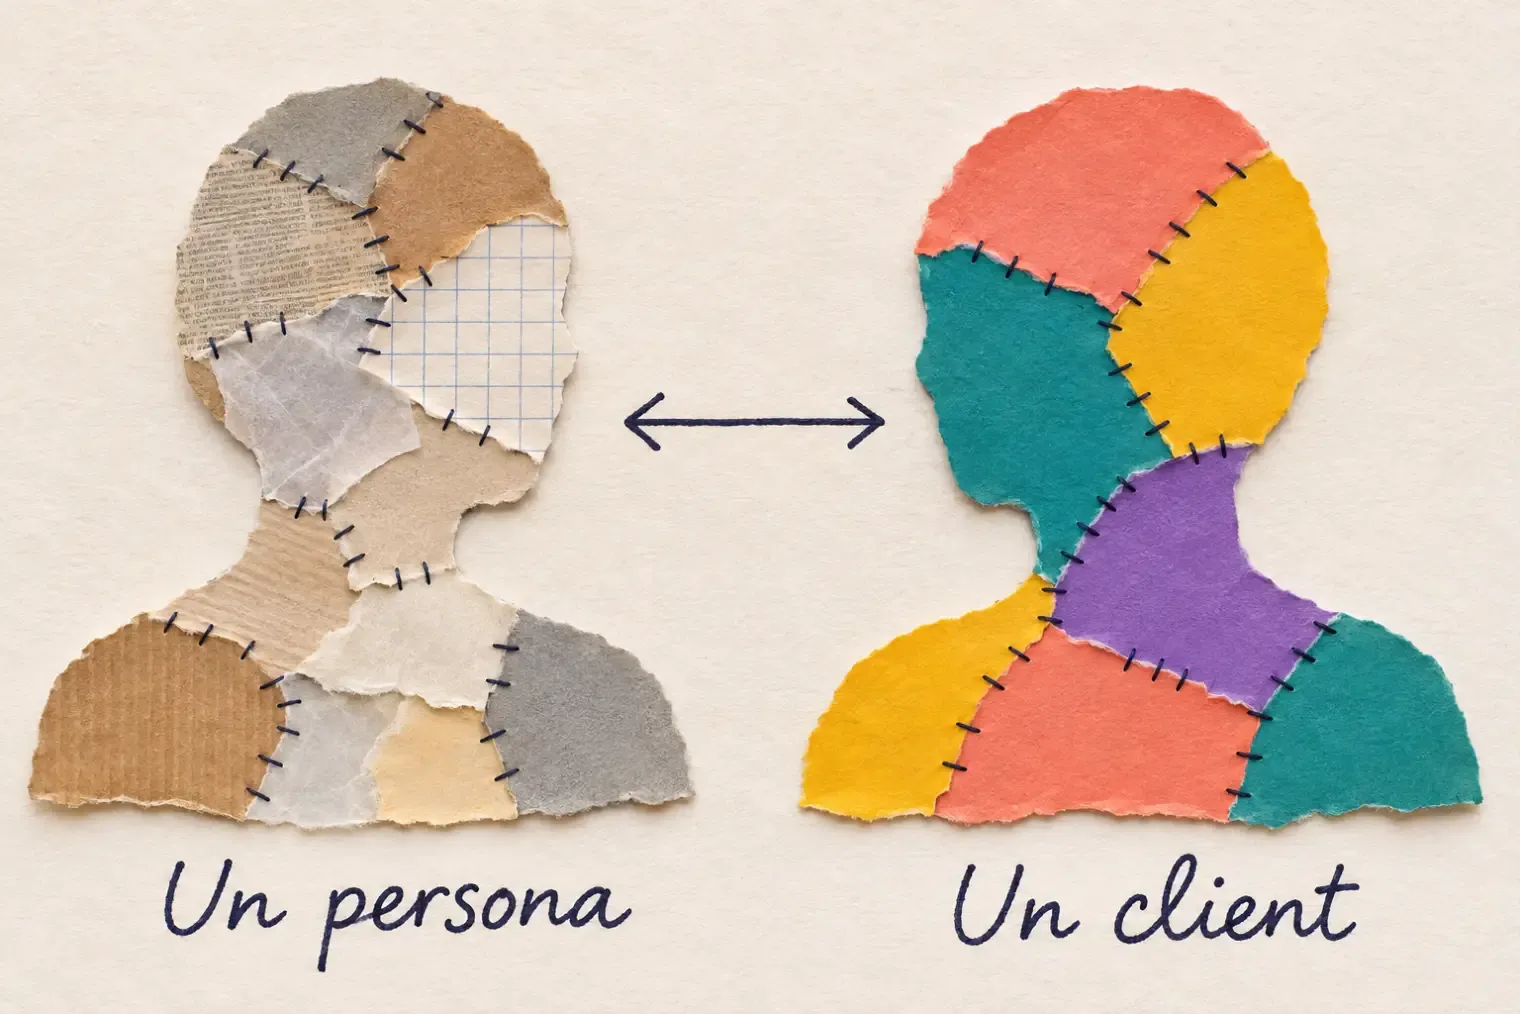
Préalable à ce petit travail de recherche, pour nous les personas sont toujours créés à partir de données réelles, mais ce sont des archétypes, des caricatures, pas de vrais utilisateurs. Un persona est donc un patchwork de clients, le barycentre d’un ensemble qui a une cohérence. Dans l’autre sens, un client est un patchwork de personas. On s’interroge sur la manière de faire tenir cette approche au moment de mettre de l’IA dedans !
On procède par étapes. La première, c’était de se demander si l’IA peut répondre à la place de vrais clients. On y a consacré un article du Lab à sable, et la réponse était plutôt non, en tout cas pas avec le niveau de qualité qu’on attend d’une recherche utilisateur. La deuxième étape, c’est ce qu’un designer ou un researcher pourrait vouloir faire : un LLM branché sur un repository ou une base de données de recherche utilisateur. Qu’est-ce qu’on peut en faire ?
Un des fantasmes qu’on nous a exposés sur des projets de personas ces dernières années, c’est de dire : « Formidable, maintenant qu’on a de la donnée utilisateur et des personas, on va pouvoir brancher les personas sur cette donnée. » Ça peut être la donnée utilisateur, le CRM, n’importe quoi : on branche les archétypes, les caricatures que sont les personas sur ces sources, comme lors d’un atelier classique, mais avec tout le côté dynamique et interactif qu’offre le LLM.
Parce que là-dessus, on ne pourra que s’accorder : un persona, c’est statique. On peut en travailler l’esthétique et l’organisation pour que l’équipe se l’approprie et l’utilise au quotidien, ce qui fonctionne d’ailleurs parfois pas trop mal, mais ça reste un support statique, et comme tout support statique, c’est un peu chiant. L’ambition d’animer les choses avec les LLM est donc parfaitement compréhensible, et pour tout dire relativement légitime : faire vivre à la fois la connaissance utilisateur et les personas qu’on s’est embêtés à construire. C’est l’ambition de cette étude.
La question qu’on se pose est donc la suivante : si on branche des personas sur la donnée en la fléchant correctement, est-ce qu’un persona arrive à utiliser les données qui lui sont rattachées pour donner une réponse pertinente ? Un persona n’est jamais que le barycentre d’un ensemble d’utilisateurs, résumé par un certain nombre de dimensions, et nécessairement pas toutes les dimensions de tous les utilisateurs : la combinatoire le rendrait impossible. Ce barycentre arrive-t-il à rendre compte de la diversité, ou est-ce qu’il moyenne ? S’il moyenne, est-ce d’une manière intéressante, ou est-ce qu’on perd beaucoup d’informations ? Si on décide de ne pas moyenner, peut-il rendre compte du groupe qu’il représente, avec ses subtilités ? Est-ce utile, pertinent, fiable ? Et si on répond non à ces deux questions (le persona moyenne-t-il bien ? rend-il compte de son groupe ?), est-ce qu’on n’abandonne pas l’idée d’un persona incarné par l’IA, pour que l’IA incarne la diversité du panel ? Et alors, avec quelle précision ?
Un persona parle pour plusieurs clients, et ces clients ne sont pas d’accord entre eux : dans nos notes, ils divergent sur 34 sujets. On teste donc trois hypothèses :
- Le persona « personnage » porte une posture qui moyenne, quelque part, le groupe dont il est représentatif.
- Le persona « personnage qui arbitre » prend les tendances à droite, à gauche, et essaie de restituer la subtilité et la diversité du groupe. Il parle toujours à la première personne, mais il cite les notes qu’il utilise et signale les désaccords entre clients.
- Le « panel » abandonne le personnage, qu’il arbitre ou non, et part uniquement sur une logique de panel. Il ne parle plus à la première personne : il présente ce que disent les clients, combien de notes abordent le sujet et quelles positions s’en dégagent, avec les codes des notes derrière chaque position.
Le banc d’essai : sept personas branchés sur leurs notes
Côté protocole, on utilise des personas constitués de manière rigoureuse, comme on sait le faire habituellement, à partir de données qualitatives et quantitatives. Chaque persona reçoit sa fiche et, associées à cette fiche, toutes les notes des clients qui lui ressemblent : entre 6 et 15 notes selon le persona, soit grosso modo 4 000 à 8 000 tokens (l’unité de texte que lit un modèle). Une note, c’est le résumé d’un entretien écrit par le chercheur, pas une transcription. L’article précédent a montré que le RAG (la recherche automatique d’extraits) n’était pas une solution efficace sur un corpus de cette taille. Cette fois, on abandonne donc l’idée : il n’y a pas de recherche d’extraits, le persona lit toutes ses notes en entier.
On pose trois types de questions : 67 points où la bonne réponse est bel et bien dans les notes, 56 pièges où le persona doit dire qu’il ne sait pas, parce que le sujet n’est pas dans ses notes, et les 34 sujets évoqués plus haut, sur lesquels on sait que les clients divergent.
Haiku et Sonnet, deux des trois modèles d’Anthropic (Opus est le plus gros), jouent le persona, et chaque question est posée 5 fois. On met Opus de côté pour des raisons économiques : c’est clairement trop cher. En revanche, c’est Opus qui juge les réponses, et un autre modèle a rejugé 100 cas complètement à l’aveugle. Il est d’accord avec Opus sur 95. Ça n’a pas été vérifié à la main, mais avec 5 % de désaccord, on s’en contente pour cette étude.
Point très important : aucune note ni citation de client n’est publiée ici, seulement des comptes. Tout est anonymisé.
Comment on sépare un écart du hasard
Avec 67 points de fond et 34 désaccords, les comptes sont petits. Pour chaque taux, on donne donc un intervalle à 95 %, calculé par la méthode exacte de Clopper-Pearson : il contient tous les taux encore compatibles avec ce qu’on a observé. Pour comparer deux consignes posées sur les mêmes questions, on utilise un test de McNemar exact, qui ne regarde que les points justes avec une consigne et faux avec l’autre. En dessous de 0,05, on considère d’habitude que l’écart est démontré.
Aucune invention sur 56 pièges
Premier point, et c’est un vrai sujet de préoccupation : les hallucinations, les inventions. Quel que soit le scénario, sur les 56 pièges, ces questions sur des sujets absents des notes, on n’observe aucune réponse inventée, et ce quel que soit le modèle, Haiku ou Sonnet. On n’a que 56 pièges. Ce qu’on peut dire, c’est que le taux d’hallucination est en dessous de 6,4 %, avec 95 % de confiance, mais on a bien eu zéro occurrence sur ces 56 pièges.
On a aussi essayé de nourrir le persona de trois autres manières. Sa fiche seule, comme témoin : sans aucune note, le modèle invente-t-il à partir du stéréotype de la fiche ? Sa fiche avec uniquement les notes des clients qui lui ressemblent le plus nettement : des groupes plus homogènes, avec moins de désaccords. Toutes les notes du projet, celles des vendeurs comprises, chacune marquée comme telle : c’est le cas réaliste du dossier entier déposé dans un outil, et le seul où l’on vérifie que le persona ne s’attribue pas ce qu’a dit un vendeur. Là non plus, aucune invention. On a peu de cas, et ces essais ont surtout tourné sur Haiku, mais c’est relativement fiable.
Le personnage oublie un point sur deux
Deuxième aspect de la qualité et de la fiabilité de l’approche : après les hallucinations, on se pose la question non pas de ce qui est inventé, mais de ce qui est oublié. Sur 67 points dont la réponse est dans les notes, Haiku en oublie 56 quand il incarne strictement un personnage, 49 quand il arbitre et 21 quand il représente le panel. Les 56 oublis du personnage sont assez logiques : comme il fait une moyenne, forcément, il n’est pas très exhaustif. Sonnet fait très nettement mieux, mais il reste très peu fiable. Il oublie un point sur deux quand il incarne un personnage, un sur trois quand il arbitre, et un peu plus d’un sur quatre quand il représente le panel.
| Consigne | Haiku, sur 67 | Sonnet, sur 67 | Intervalle à 95 %, Sonnet |
|---|---|---|---|
| Persona « personnage » | 56 | 37 | 43 à 67 % |
| Persona « personnage qui arbitre » | 49 | 23 | 23 à 47 % |
| « Panel » | 21 | 19 | 18 à 41 % |
Trait noir à butées : intervalle à 95 %. Piste grise : les 67 sous-questions de fond.
Voir les données
| Consigne | Haiku : oubliées sur 67 | Haiku : intervalle à 95 % | Sonnet : oubliées sur 67 | Sonnet : intervalle à 95 % |
|---|---|---|---|---|
| Persona « personnage » | 56 | 72,5 à 91,5 % | 37 | 42,6 à 67,4 % |
| Persona « personnage qui arbitre » | 49 | 60,9 à 83,2 % | 23 | 23,2 à 46,9 % |
| « Panel » | 21 | 20,6 à 43,8 % | 19 | 18,0 à 40,7 % |
Même avec un panel, on perd donc beaucoup plus d’insights utilisateurs que dans l’étude précédente. En lisant tous les entretiens, l’IA n’y faisait que 2 erreurs sur 53, alors qu’ici on en a 19 sur 67. Avec Sonnet, l’écart est significatif entre le personnage et le panel, et aussi entre le personnage et le personnage qui arbitre (test de McNemar, p inférieur à 0,0001 dans les deux cas). Entre le personnage qui arbitre et le panel, on ne peut pas trancher (p = 0,76).
L’IA est en revanche stable dans son manque de fiabilité. Avec Sonnet, en panel, elle ne change de verdict entre les 5 essais que sur 12 questions sur 215 (celles où l’on attend une réponse stable, désaccords exclus), contre 49 quand elle incarne le personnage.
Enfin, on a testé Opus en panel, sur 24 points seulement. Il en rate 6, que Sonnet avait déjà ratés. C’est un modèle beaucoup plus gros et beaucoup plus cher, et il n’efface pas ces oublis.
Alors comment on se l’explique ? Honnêtement, on ne sait pas. Ce n’est pas la quantité d’information : chaque persona n’a que 4 000 à 8 000 tokens à lire, moins que dans l’article précédent, où l’IA ne ratait que 2 points sur 53. On n’est donc pas dans la situation de l’aiguille dans une botte de foin. Sur un gros corpus, en revanche, on y serait, et on n’a pas comparé un RAG à une fenêtre de contexte surchargée.
On a regardé ce qu’on pouvait mesurer avec les données dont on dispose. Ce n’est pas le nombre de clients : avec Sonnet, un persona qui en porte 15 n’oublie pas plus qu’un persona qui en porte 6. Ce n’est pas non plus la place de la note dans la pile, on ne voit pas d’oubli particulier au milieu. Et les points ratés ne sont pas des faits plus difficiles que les autres : avec Sonnet, le panel et le personnage en ratent 12 en commun, à peine plus que les 10,5 qu’on attendrait si chacun ratait ses points au hasard.
Avec Sonnet, deux tendances reviennent avec les trois consignes. Les notes du début de la pile sont un peu mieux retenues. Et les faits des clients que le persona partage avec d’autres personas sont plus souvent oubliés que ceux des clients qui ressemblent surtout à lui : en panel, c’est 12 sur 37 contre 3 sur 23. Cette seconde tendance va dans le sens de notre point de départ, mais aucun de ces écarts n’est démontré statistiquement, et avec 7 personas, on ne peut pas aller plus loin.
Dernier constat : sur les 67 points, 7 viennent de la fiche du persona plutôt que d’une note de client. Avec Sonnet, le panel oublie 4 de ces 7 faits, là où le personnage n’en oublie aucun. C’est assez logique, puisque le panel rapporte ce que disent les clients, et que la fiche n’en fait pas partie.
Quand les clients ne sont pas d’accord
Reste la situation particulière des clients qui appartiennent à un même ensemble, représentés par un même persona, mais dont les avis divergent. On avait identifié 34 sujets sur lesquels les clients associés à un même persona divergent. Sur ces 34 sujets, avec Sonnet, le personnage ne signale le désaccord que sur 5. Sur 14, il donne un seul avis, toujours le même, sans dire que d’autres clients pensent le contraire. Il change d’avis d’un essai à l’autre sur 3 sujets, il invente une position intermédiaire qu’aucun client n’a exprimée sur 2, et il répond surtout « je n’en ai pas parlé » sur 10.
Chaque modèle compte les 34 thèmes une fois, dans un seul comportement.
Voir les données
| Ce que fait le persona « personnage » | Haiku, sur 34 | Sonnet, sur 34 |
|---|---|---|
| Signale le désaccord | 4 | 5 |
| Un seul avis, toujours le même | 10 | 14 |
| Change d'avis | 5 | 3 |
| Invente une position intermédiaire | 0 | 2 |
| Répond surtout qu'il n'a pas abordé le sujet | 15 | 10 |
| Ce que fait le persona « personnage », sur 34 désaccords | Haiku | Sonnet |
|---|---|---|
| Il signale le désaccord | 4 | 5 |
| Il donne un seul avis, toujours le même | 10 | 14 |
| Il change d’avis d’un essai à l’autre | 5 | 3 |
| Il invente une position intermédiaire | 0 | 2 |
| Il répond surtout qu’il n’a pas abordé le sujet | 15 | 10 |
Le personnage qui arbitre et le panel jouent pleinement leur rôle, puisque c’est ce que leur consigne leur demande : ils signalent les désaccords 34 fois sur 34. Le revers, c’est qu’on avait aussi posé 17 sujets sur lesquels les clients étaient d’accord. Le panel y voit un désaccord inexistant dans 7 cas sur 17, et le personnage qui arbitre dans 10 cas sur 17.
Des avis qui changent
Autre sujet, la stabilité dans le temps. Le personnage semble changer d’avis d’un essai à l’autre sur 5 sujets avec Haiku et sur 3 avec Sonnet. Sur ces 8 sujets au total, il n’y en a que 2 où le modèle alterne vraiment entre l’avis d’un client et celui d’un autre (un avec chaque modèle, avec 4 essais pour un avis et 1 pour l’autre). Les 6 autres mélangent un avis de client avec une réponse « je n’en ai pas parlé », ou avec une position intermédiaire qu’aucune note ne contient. La confusion entre deux avis présents dans les notes n’arrive donc que 2 fois sur 8.
Personnage ou panel : aucun ne passe
Si on doit tirer un bilan de l’ensemble, quelle que soit la modalité, persona « personnage », « personnage qui arbitre » ou « panel », aucune solution ne donne des résultats de bonne qualité. On a testé 15 réglages : 3 consignes, 2 modèles, plusieurs façons de donner les notes. Aucun ne respecte tous les seuils qu’on s’était fixés avant les essais, par exemple pas plus de 3 oublis sur 67 points. Même le meilleur, le panel avec Sonnet, est assez loin du compte : 19 oublis quand on en acceptait 3, 12 points où la réponse change d’un essai à l’autre pour un seuil à 10, et 7 désaccords vus là où les clients sont d’accord, alors qu’on n’en acceptait qu’un. Ces seuils étaient arbitraires, certes, mais on est quand même très loin du compte.
Le fond du problème, c’est la formulation du problème. Un persona qui incarnerait la diversité des avis utilisateurs ne saura jamais l’incarner d’une seule voix. Il dira forcément « certains pensent ceci, d’autres pensent cela ». Dans le meilleur des cas, s’il est fidèle, ce n’est plus un persona, c’est un compte rendu de panel. Et si on le force à être un persona, il est obligé de choisir un camp. C’est ce que fait Sonnet sur 14 des 34 désaccords, et il le fait sans prévenir.
La conclusion, c’est qu’on peut envisager d’utiliser un LLM comme front à une base de données d’insights, de recherche utilisateur. C’est possible. Ce n’est vraisemblablement pas possible par le biais de personas, comme pas mal de monde essaie visiblement de le faire en ce moment. Et quand on y pense, ça tombe sous le sens. En plus, et c’est une réserve plus globale, le panel n’est pas fiable, il n’est pas fidèle, sans compter qu’il n’est pas un personnage. C’est pourtant la seule alternative qui offre un minimum de qualité, et elle n’atteint même pas le niveau qu’on s’était fixé.
Les limites de cette étude
On a travaillé sur un seul projet et sept personas, avec des notes résumées par des chercheurs plutôt que des transcriptions, et des questions fermées. Les bonnes réponses ont été écrites par une seule personne. Sur un des critères, le rangement des notes sous chaque position, une relecture par quelqu’un d’autre a trouvé une réponse attendue fausse et deux discutables. Le juge est un modèle, tout comme celui qui a rejugé 100 cas à l’aveugle. Pour une question de coût, on s’est arrêté à Sonnet : Opus n’a tourné que sur 24 points. Et avec sept personas, on ne peut pas aller plus loin que des pistes pour expliquer les oublis.
À quoi ça peut servir ?
Dans le fond, ça a le mérite de réinterroger l’intérêt de la méthode des personas. Depuis toujours, elle a été créée pour susciter de l’empathie. Il y a toujours cette demande, parfaitement compréhensible et légitime, de rattacher les personas à des données tangibles. Tout au long de la vie de l’agence, sur les projets où on a conçu des personas, on a vu très régulièrement, pour ne pas dire systématiquement, des équipes nous demander dans quelle mesure ces personas pourraient être reliés aux données du CRM, par exemple. On en parlait déjà dans un article du blog sur les personas et le CRM. Très honnêtement, qu’on veuille les relier au CRM, aux insights utilisateurs en général ou à un research repository, la problématique est exactement la même. C’est légitime de vouloir faire le lien avec de la donnée, mais ça n’a jamais été le propos des personas : ils n’ont jamais eu vocation à être simplement une porte d’entrée vers des données.
Chez Alan Cooper, dans The Inmates Are Running the Asylum, le persona sert d’abord à se projeter : « We become character actors, inhabiting the minds of our personas. » Et il assumait la caricature : « Stereotypical personas are more effective if the stereotyping lends more credence to the persona […] I am shooting for believability, not diversity. » Il visait la crédibilité, pas la diversité, alors que c’est la diversité de ses clients qu’on demande ici au persona IA de restituer.
Un persona est censé créer de l’empathie, s’appuyer sur une logique floue, permettre de se projeter. La recherche utilisateur et les méthodes qualitatives ne donnent pas de vérité, les personas non plus. Quand on caricature une approche qui donne par essence une vision floue de la réalité, on ne va pas considérer qu’on a un moyen d’accéder mieux à la vérité, qu’on mette des LLM dans la boucle ou pas. On ne peut pas espérer créer de la caricature et, par le truchement de cette caricature, accéder à de la fidélité. Il y a quelque chose de l’ordre de la contradiction là-dedans.
Si on choisit malgré tout de faire incarner ces personas par l’IA, la meilleure piste n’est peut-être pas de lier de la donnée réelle aux personas, mais de leur offrir plus d’épaisseur, un background. On reste dans le flou, dans la moyenne, on ne va pas chercher l’insight précis, mais peut-être un flou un peu différent, qui va un peu plus loin. On reste dans la caricature, et les insights resteront caricaturaux : ils ne rendent pas compte de la subtilité, de la singularité de ce qui a été collecté. Mais on peut sans doute aller un peu plus loin que des fiches PDF, en incarnant, en donnant une voix.
Le fond du truc, c’est qu’on peut envisager qu’un LLM soit un front interactif, conversationnel, génératif, à des données collectées, et qu’il en soit le traducteur relativement fidèle, mais pas parfaitement fidèle. Ce n’est alors plus vraiment un persona, plutôt un front conversationnel à un research repository, qui doit être bien tagué. Et si on considère que la fidélité se trouve dans les démarches qualitatives, il est assez vraisemblable qu’on ne puisse pas remplacer la fidélité sur des échantillons faibles par de l’invention pure, qui serait une espèce de moyenne. La question se pose donc de savoir s’il est bien raisonnable de persister à faire parler des personas branchés sur la donnée.
Une autre perspective serait d’utiliser la capacité d’indexation et d’information retrieval pour aller chercher des informations dans une base de données. Mais là aussi, on a des erreurs : on s’expose à ce que des informations qui existent bel et bien soient tout bêtement oubliées. La capacité principale d’un LLM, c’est de générer du contenu, pas d’indexer correctement.
Dernier point, il pourrait être utile de vérifier si on améliore la qualité en taguant plus et mieux. Mais taguer plus et mieux, c’est un travail plus besogneux, et on peut se demander si on n’introduirait pas de nouveaux biais en cédant à la facilité, très légitime elle aussi, de confier cet étiquetage à une IA. C’est un sujet pour un futur article.
Ou bien on retourne voir les utilisateurs.
Texte et illustration réalisés avec l’aide de l’IA, sous la supervision de l’équipe (voir notre déclaration d’usage de l’IA).