




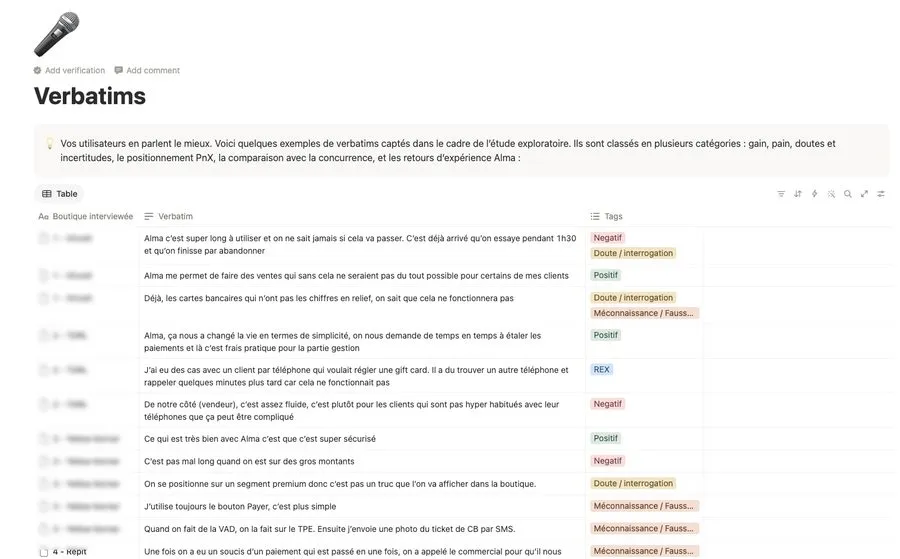
Le research repository est la base centralisée où sont stockés et organisés les enseignements issus des études utilisateurs. Au-delà du stockage, le research repository aide au rayonnement des résultats de la recherche. Un repository est utile seulement s’il réussit à s’intégrer dans les pratiques de l’organisation, ce qui suppose un travail de co-définition et de structuration important.
Le research repository est l’endroit où le travail de recherche devient consultable et réutilisable.
01
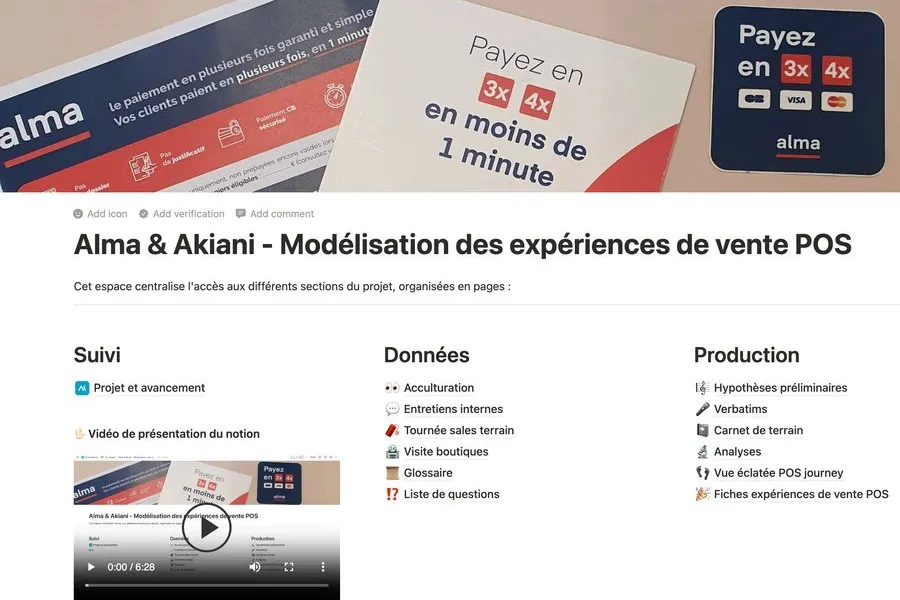
La boîte à outils interne
des descriptions des méthodes de recherche, des outils et des modèles pour mener et analyser des recherches.
02
La feuille de route research
une roadmap, un planning avec la méthode de recherche et ce qui est étudié, en mettant en avant les derniers résultats obtenus.
03
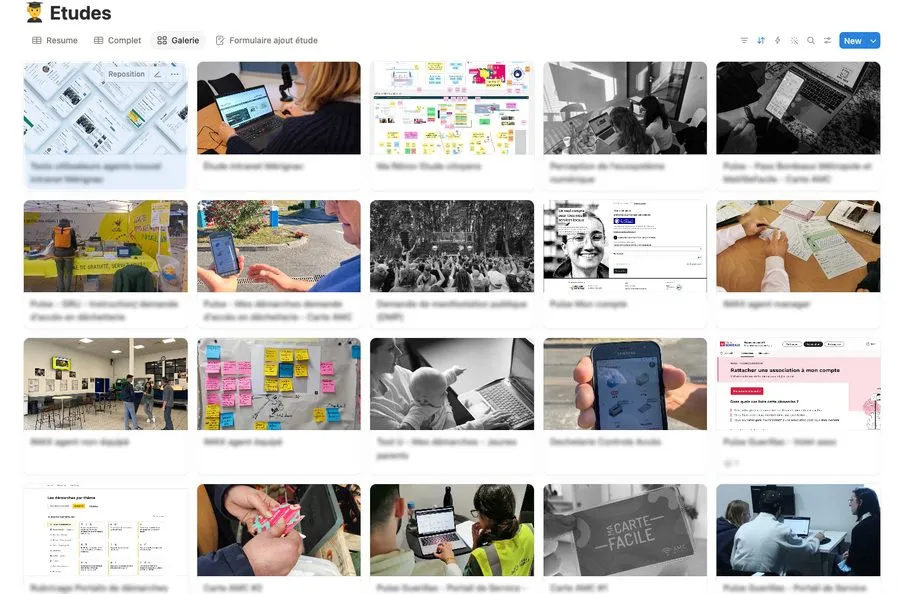
Les études réalisées
des plans de recherche détaillés indiquant les objectifs, les moyens utilisés, et ce qu’on a appris une fois l’étude restituée.
04
Les livrables
le rapport de recherche, qui décrit ce qui s’est passé dans l’étude : thèmes généraux, conclusions détaillées et parfois recommandations.
05
Les insights
chaque étude produit un nombre réduit de constats. En les taguant et en y liant des preuves issues d’une ou plusieurs études, ils deviennent le cœur du repository : l’atome au sens de l’atomic research.
06
Les données (pas systématique)
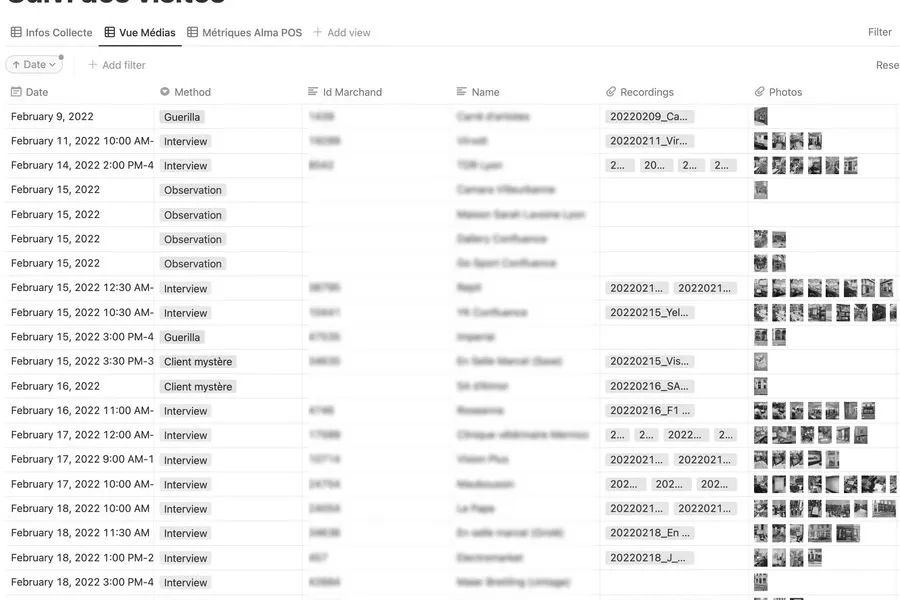
un accès à des enregistrements et transcriptions stockés dans le référentiel ou, sinon, liés depuis le référentiel à des notes brutes et aux artefacts des sessions de recherche.
Il y a autant de routes que de modèles d’organisation, mais on retrouve systématiquement les étapes suivantes.
01
Inventorier toute la matière disponible
Une organisation dispose presque toujours de plusieurs sources qui alimentent la connaissance de ses utilisateurs. L’idée est d’en faire la liste, en décrivant pour chacune ce qu’elle est, d’où elle vient, par qui elle est gérée, à quoi elle sert et ce qu’on en apprend.
02
Définir la structure de données
On parle ici de la structure de la base : faut-il des tags ? Les personnes qui vont y accéder veulent-elles un PDF de rapport complet ou une liste de résultats clés à exporter ? Ont-elles besoin de savoir qui sont les utilisateurs interrogés pour une étude donnée ? Ces questions se tranchent avant de se lancer, éventuellement avec un petit groupe pilote pour dégrossir le sujet.
03
Rendre la base de connaissance accessible
C’est l’étape sans laquelle tout le travail précédent est perdu. Une fois l’outil choisi, dédié ou plus générique, encore faut-il l’intégrer dans le reste de l’écosystème de l’entreprise : publier un message à chaque ajout d’une étude, exiger ou non un identifiant pour accéder au contenu, mettre en avant certaines mises à jour lors des rituels internes. Toutes les occasions sont bonnes pour tester l’appétence pour l’outil et voir comment continuer à l’améliorer.
04
Alimenter en continu
Ajouter une étape dans un cycle projet déjà tendu peut inquiéter, mais une des conditions de succès du repository, c’est la fraîcheur des connaissances qu’il apporte. Chaque nouvelle étude doit s’y retrouver le plus vite possible. Idéalement, son entrée a été créée en amont du lancement avec les objectifs, les moyens, etc., et le lien de l’étude est partagé avec le livrable et les résultats une fois disponibles, plutôt que par mail ou message direct.
05
Gouverner le research repository
C’est le point le plus important. Le research repository est un produit interne : s’il n’a pas de gouvernance, il n’aura pas d’existence pérenne. La gestion des contenus, l’administration des accès, la promotion de l’outil, l’aide à la prise en main, tout cela prend du temps et sont des conditions nécessaires à l’utilisation d’un research repository. Il faut définir quelques rôles et que les fonctions associées à chaque rôle soient assurées avec régularité.
Si l’on souhaite mettre en place une démarche d’amélioration continue qui s’appuie sur des retours utilisateurs réels, le research repository est la solution parfaite. Sans cela, chaque étude utilisateur est cloisonnée et ses résultats sont diffusés de façon très réduite. On peut facilement réinventer la roue alors qu’un repository capitalise sur les sujets déjà étudiés, et les résultats obtenus.
Le research repository est un outil, l’atomic research est une méthode pour structurer les données d’études. En général, les research repository s’appuient sur l’atomic research. On peut tout à fait se limiter à un archivage des rapports dans un repository basique, cela ne nécessite pas de faire appel à l’atomic research.
Tout part d’un état des lieux. Quelles sont les questions que l’on a déjà creusées ? Quels résultats avons-nous obtenus ? Qu’est-ce que l’on souhaiterait partager en interne. Une fois qu’on a fait le tour, on se pose la question du format et des informations que l’on souhaite mettre en avant. On recommande de débuter avec un petit groupe de personnes qui sont producteurs ou consommateurs de données d’études et d’y aller progressivement. Mieux vaut un repository incomplet mais consulté qu’un listing parfaitement détaillé qui n’est utilisé par personne.
Attention, il est assez rare que le repository soit ouvert à tous en écriture. Ce qu’il faut, c’est définir une procédure de soumission (et de vérification) qui soit la plus simple et la plus intégrée possible dans l’environnement logiciel. Toute barrière supplémentaire serait un excellent prétexte pour se décourager. Comme dit plus haut, un repository est un vrai produit interne, qui nécessite une gouvernance dédiée.


Research Ops organise la pratique de l’UX research dans une organisation : méthodes, outils, recrutement, diffusion de la connaissance utilisateur.
En savoir plus sur Research OpsL'Atomic Research décompose vos études UX en faits, enseignements et recommandations réutilisables d'un projet à l'autre.
En savoir plus sur Atomic researchLe protocole décrit les conditions, les moyens et le déroulement d'une expérimentation ou d'un test, et les questions auxquelles on souhaite répondre.
En savoir plus sur Protocole expérimentalLe design ops optimise la pratique du design : outils, processus, handoff, documentation. Il permet aux designers de se concentrer sur la conception plutôt que sur la gestion.
En savoir plus sur Design OpsFigma est l'outil de design collaboratif de référence : conception, prototypage, design system et handoff dans un SaaS qui relie designers et développeurs.
En savoir plus sur FigmaTout le monde parle experience utilisateur, design de service, ergonomie...
C'est pas très clair, mais vous aimeriez bien découvrir tout ca ou progresser.